Криптоагрегатор на 20 000 страниц: от массовой генерации к управляемой видимости
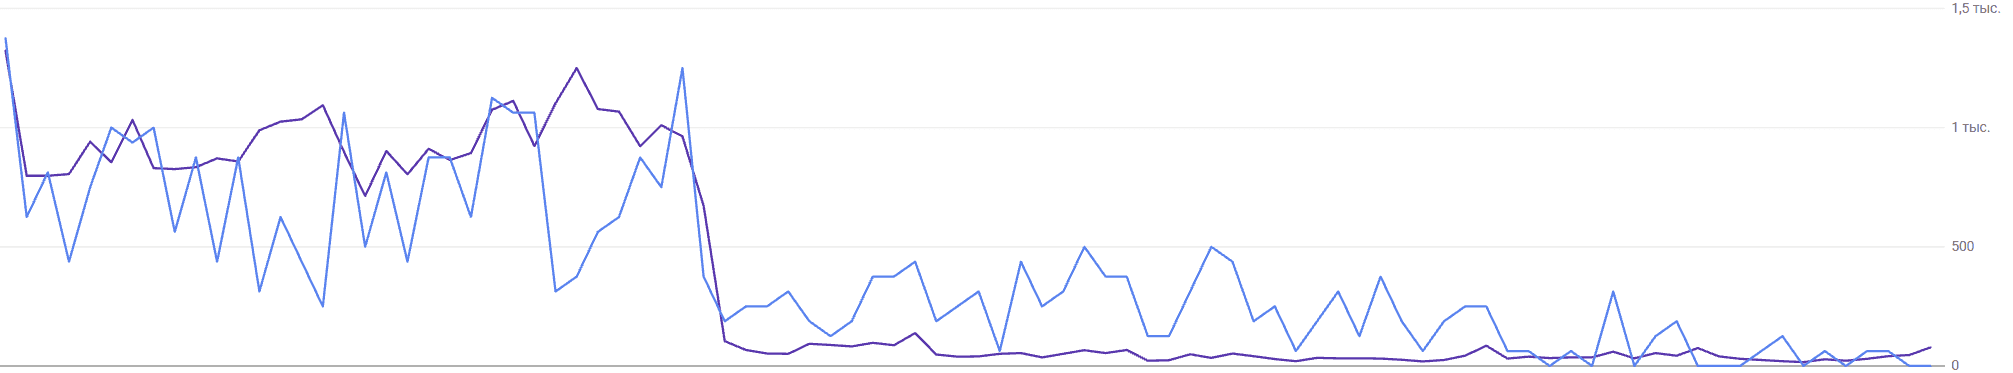
У агрегатора направлений обмена криптовалют было около 20 000 программатик-страниц. До августовского обновления Google 2026 года сайт получал стабильные десятки кликов в день. Затем показы и клики в Search Console упали почти до нуля. Задача: вернуть видимость по направлениям с реальным спросом и перестать расходовать ресурсы на страницы без пользы для посетителя.
Короткий итог: приоритетные страницы стали устойчивее держаться в индексе, а видимость по целевым запросам начала восстанавливаться. Работа заняла месяцы и продолжается.
Бизнес-цель и исходные условия
Агрегатор работал с направлениями обмена для аудитории в Грузии, Таиланде, на Кипре и в Сербии. Страницы создавались по шаблонам для множества валютных пар и языковых версий. Масштаб охватывал длинный хвост запросов, но сам по себе ценности не создавал: FAQ отличались подстановкой переменных, а часть отзывов об обменниках была скопирована с других сайтов.
После падения трафика расширять каталог не имело смысла. Сначала нужно было понять, какие направления реально нужны пользователям, какие страницы удерживаются в индексе и что мешает релевантным страницам получать показы.
Диагностика: проблема шире одной технической ошибки
Я увидел два повторяющихся паттерна:
- Страницы не удерживались в индексе. Они появлялись в поиске, но по мере роста числа индексируемых URL часть массово выпадала из выдачи Google и Яндекса.
- Поиск выбирал не ту страницу. По русскоязычному запросу могла показываться английская версия и наоборот; иногда пара направлений на странице не соответствовала запросу.
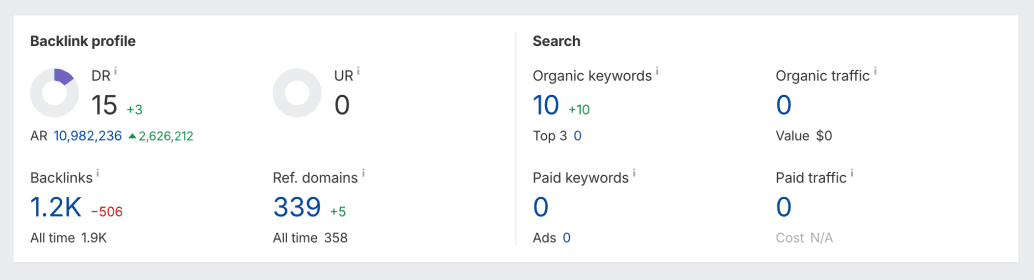
Параллельно сайт отдавал ошибки 503 при нагрузке на сервер и API — это мешало и обходу, и пользователям. Ahrefs показывал слабую поисковую видимость и небольшой пул запросов по обмену криптовалют.
Совпадение падения с обновлением Google не доказывает ни ручную санкцию, ни то, что обновление было единственной причиной. Но масса страниц без собственной ценности — очевидный риск: правила Google отдельно описывают масштабное создание малооригинальных страниц ради ранжирования, независимо от того, сделаны они с помощью AI или нет.
Стратегия: меньше страниц, больше пользы на каждом направлении
Мы разделили каталог по спросу и потенциалу. Приоритет получили направления, по которым пользователь действительно ищет обмен и сравнивает варианты. Таким страницам нужно было обеспечить три вещи: устойчивую доступность, понятную языковую релевантность и собственные данные для выбора обменника. Страницы без этого потенциала не должны конкурировать за ресурсы обхода и внимание команды.
Так работа превратилась из «оптимизации 20 000 URL» в управляемый процесс: отбор направлений → качество данных → публикация и индексация → мониторинг видимости.
Что внедрили
Правила индексации. Тонкие страницы с редкими или бесполезными направлениями закрыли от индексации и убрали из sitemap. В админке появился механизм noindex по правилам с чёрным и белым списками — чтобы не разбирать каждый URL вручную при изменениях каталога.
Очистку каталога. Удалили направления с единственным обменником и комбинации без реального пользовательского сценария, а также локализации вне фокусных рынков (включая PT и ES).
Собственный слой данных. Вместо скопированных отзывов — рейтинг, показатели доверия и оценка обменника. Эти данные помогают сравнивать варианты и дают странице больше смысла, чем замена валютной пары в шаблоне.
Связи между направлениями. Добавили переходы к обратным и похожим направлениям и объединили связанные страницы в кластеры. Пользователь получил путь к альтернативам, а важные страницы — более ясное место в структуре.
Техническую стабильность. Устранили массовые 503 при нагрузке на сервер и нестабильной работе API. Проверяли через PageSpeed, GTmetrix и технический обход; индексацию отслеживали через «Арсенкин» и Яндекс.Вебмастер.
Путаницу языковых версий разбирали отдельно: сверяли содержимое страницы с её языком и корректность связей между версиями. Для таких сайтов Google рекомендует отдельные URL и hreflang. При этом я не утверждаю, что один hreflang объяснял или исправил падение.
Результат и его границы
Быстрого возврата трафика не было. Сначала приоритетные страницы стали устойчивее держаться в индексе, а страницы без ценности перестали раздувать каталог. После следующего обновления поиска видимость по отслеживаемым запросам начала расти, часть страниц поднялась выше.
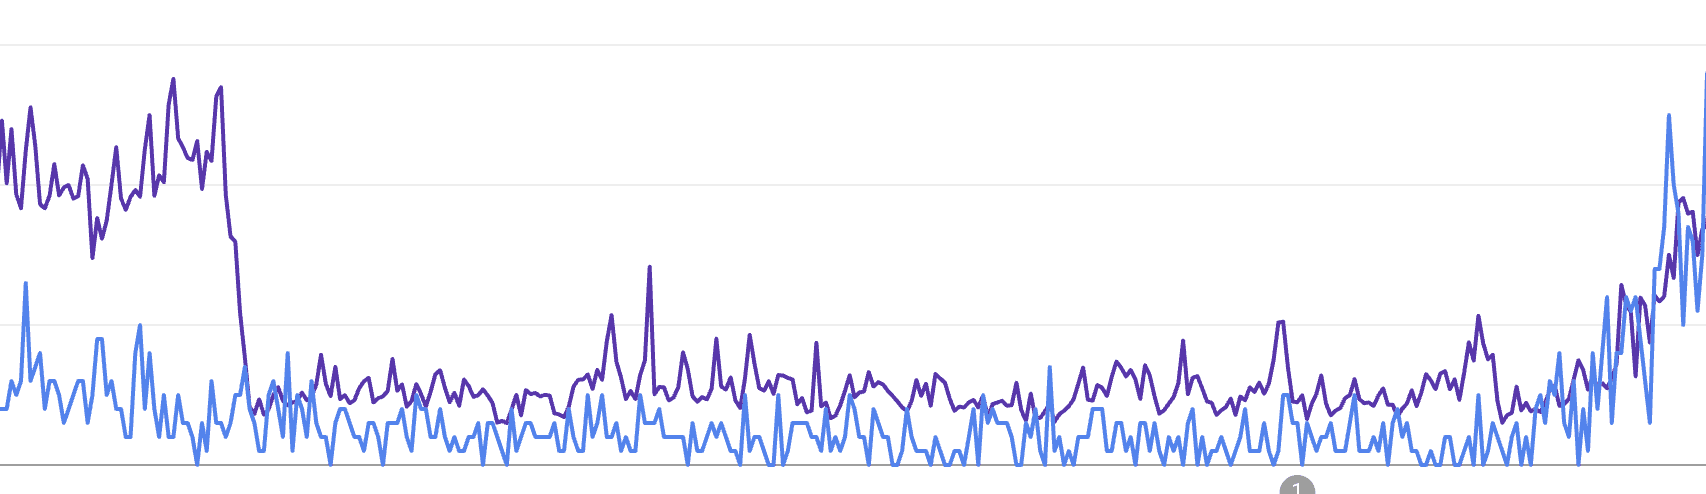
График показывает направление изменений, а не точный прирост: исходный снимок без дат и подписей рядов.
Позиции по русскоязычным кластерам измерялись для Москвы, англоязычные страницы — для Нью-Йорка, но этот кластер не был приоритетом. Следующий этап — усиление выбранных страниц ссылками и проверка их устойчивости в индексе.
Чтобы количественно оценить восстановление и вклад в бизнес, нужны сопоставимые периоды в Search Console, число оставшихся индексируемых страниц и данные по целевым действиям. Пока этих значений нет, я не называю ни процент возврата трафика, ни число лидов.
Что проверить на другом крупном программатик-сайте
- Удерживаются ли новые страницы в индексе спустя время, а не только сразу после публикации?
- Есть ли на странице собственные данные или функция, полезные при выборе?
- Охватывают ли индексируемые шаблоны реальный спрос, включая запросы ближе к покупке?
- Отдают ли важные страницы стабильный ответ при нагрузке?
- Совпадают ли язык страницы, запрос и языковая версия в выдаче?
Сам факт генерации страниц — не санкция. Риск появляется, когда масштаб подменяет пользу, а команда измеряет количество URL вместо видимости нужных направлений и действий пользователей.
Если у вашего сайта похожая динамика индексации, напишите мне. Начнём с проверки страниц, которые должны приводить целевой спрос, и причин, по которым они его не получают.